Volver al índice de Big Data · Práctica 2: Apache Spark
Práctica 1: Limpieza de datos en Online Retail
Asignatura: C703 · Big Data / Big Data
Alumno: Eduardo Alonso Sánchez · Boleta: 2023630155
Grupo: 7CV4 · Docente: Tania Rodríguez Sarabia · Periodo: 20271
Descargar reporte PDF · Notebook ejecutado · Resumen de resultados JSON
1. Objetivo y datos de entrada
El objetivo fue construir un proceso reproducible de carga, validación, limpieza, transformación y exportación de datos transaccionales. Trabajé con Online Retail, que reúne operaciones de un comercio británico entre diciembre de 2010 y diciembre de 2011. La descripción de UCI identifica los folios que comienzan con la letra C como cancelaciones y expresa los precios en libras esterlinas.
Utilicé la copia CSV de Databricks. La carga produjo 541,909 filas y ocho columnas: InvoiceNo, StockCode, Description, Quantity, InvoiceDate, UnitPrice, CustomerID y Country.
El análisis se ejecutó sobre el DataFrame completo. Las 155 filas de df_visualizacion se usaron únicamente para mostrar una parte del conjunto. La huella SHA-256 del archivo original permite comprobar el insumo de una reejecución:
a2f79bbdd4463df6db8a3f5a50b9c980ae8f645a370bf5e2c0d6097f9e817b052. Configuración y exploración inicial
La personalización usa 0155 como cadena en nombres, etiquetas y búsquedas, y 155 como entero para paridad y módulos. Conservé el cero inicial en el identificador escrito. El tamaño de visualización fue 155 % 100 + 100 = 155.
boleta_completa = "2023630155"
identificador = boleta_completa[-4:]  # "0155"
digitos_boleta = int(identificador)   # 155

df = pd.read_csv(
    RAW_PATH,
    encoding="utf-8",
    dtype={"InvoiceNo": "string", "StockCode": "string"},
)
columnas_fuente = df.columns.tolist()
N = digitos_boleta % 100 + 100
df_visualizacion = df.head(N).copy()
La exploración incluyó las primeras filas, los tipos, las estadísticas descriptivas y el conteo de nulos. InvoiceNo y StockCode se conservaron como texto para no perder los códigos alfanuméricos.
3. Tratamiento de valores nulos
Encontré 135,080 valores faltantes en CustomerID y 1,454 en Description. No hubo folios de factura nulos.
| Columna | Nulos iniciales | Porcentaje |
|---|---|---|
| CustomerID | 135,080 | 24.926694 % |
| Description | 1,454 | 0.268311 % |
| InvoiceNo | 0 | 0 % |
Como 155 es impar, imputé CustomerID con 10000 + 155 = 10155. Las descripciones faltantes recibieron NO_DESCRIPCION_0155.
customer_id_imputado = 10000 + digitos_boleta
df["CustomerID"] = df["CustomerID"].fillna(customer_id_imputado).astype("Int64")
df["Description"] = df["Description"].fillna(f"NO_DESCRIPCION_{identificador}")
df = df.dropna(subset=["InvoiceNo"]).copy()
El valor 10155 representa un cliente desconocido. El resultado tiene 4,373 identificadores, pero sólo 4,372 corresponden a clientes presentes en el archivo original. Las transacciones imputadas no permiten identificar a una persona común.
4. Duplicados y redundancia
Detecté 5,268 duplicados exactos. La eliminación usó la clave de negocio InvoiceNo, StockCode y CustomerID, conservando la primera aparición. Esta regla es distinta de comparar todas las columnas y retiró 10,684 filas (1.971549 %). Quedaron 531,225 registros.
df["Fila_Original"] = df.index.astype("int64") + 1
duplicados_exactos = int(
    df.duplicated(subset=columnas_fuente, keep="first").sum()
)
clave_negocio = ["InvoiceNo", "StockCode", "CustomerID"]
df = df.drop_duplicates(subset=clave_negocio, keep="first").copy()
Fila_Original conserva la posición ordinal en el CSV de entrada. La columna se excluyó de la definición de duplicado exacto para que la auditoría no alterara el conteo.
5. Tipos y reglas de negocio
Convertí InvoiceDate con el formato mes/día/año y hora. Las 531,225 fechas se reconocieron. También convertí cantidad y precio a tipos numéricos. Antes del ajuste de valores extremos guardé las cantidades, los precios y los importes originales.
df["InvoiceDate"] = pd.to_datetime(
    df["InvoiceDate"], format="%m/%d/%Y %H:%M", errors="coerce"
)
df["Quantity"] = pd.to_numeric(df["Quantity"], errors="coerce")
df["UnitPrice"] = pd.to_numeric(df["UnitPrice"], errors="coerce")
df["Quantity_Original"] = df["Quantity"]
df["UnitPrice_Original"] = df["UnitPrice"]
df["Total_Transaccion_Original"] = (
    df["Quantity_Original"] * df["UnitPrice_Original"]
)
df["Transaccion_Valida"] = (
    (df["Quantity_Original"] > 0) & (df["UnitPrice_Original"] > 0)
)
df["Es_Cancelacion"] = df["InvoiceNo"].str.upper().str.startswith("C", na=False)
La regla de cantidad y precio positivos produjo 519,582 transacciones válidas según los valores originales. La bandera de cancelación identificó 9,139 filas y se conservó después de las transformaciones.
6. Valores extremos y capping
Para detectar valores atípicos calculé Q1 = 1, Q3 = 10 e IQR = 9. Los límites del rango intercuartílico fueron −12.5 y 23.5; 58,337 registros quedaron fuera de ellos. Para corregir Quantity apliqué el recorte asignado a la terminación de boleta: percentiles 5 y 95, equivalentes a 1 y 30.
Q1 = df["Quantity_Original"].quantile(0.25)
Q3 = df["Quantity_Original"].quantile(0.75)
IQR = Q3 - Q1
mascara_outlier_iqr = ~df["Quantity_Original"].between(
    Q1 - 1.5 * IQR, Q3 + 1.5 * IQR
)

p5 = df["Quantity_Original"].quantile(0.05)
p95 = df["Quantity_Original"].quantile(0.95)
df["Quantity"] = df["Quantity_Original"].clip(lower=p5, upper=p95)
df["Cantidad_Capeada"] = df["Quantity"].ne(df["Quantity_Original"])
df["Total_Transaccion"] = df["Quantity"] * df["UnitPrice"]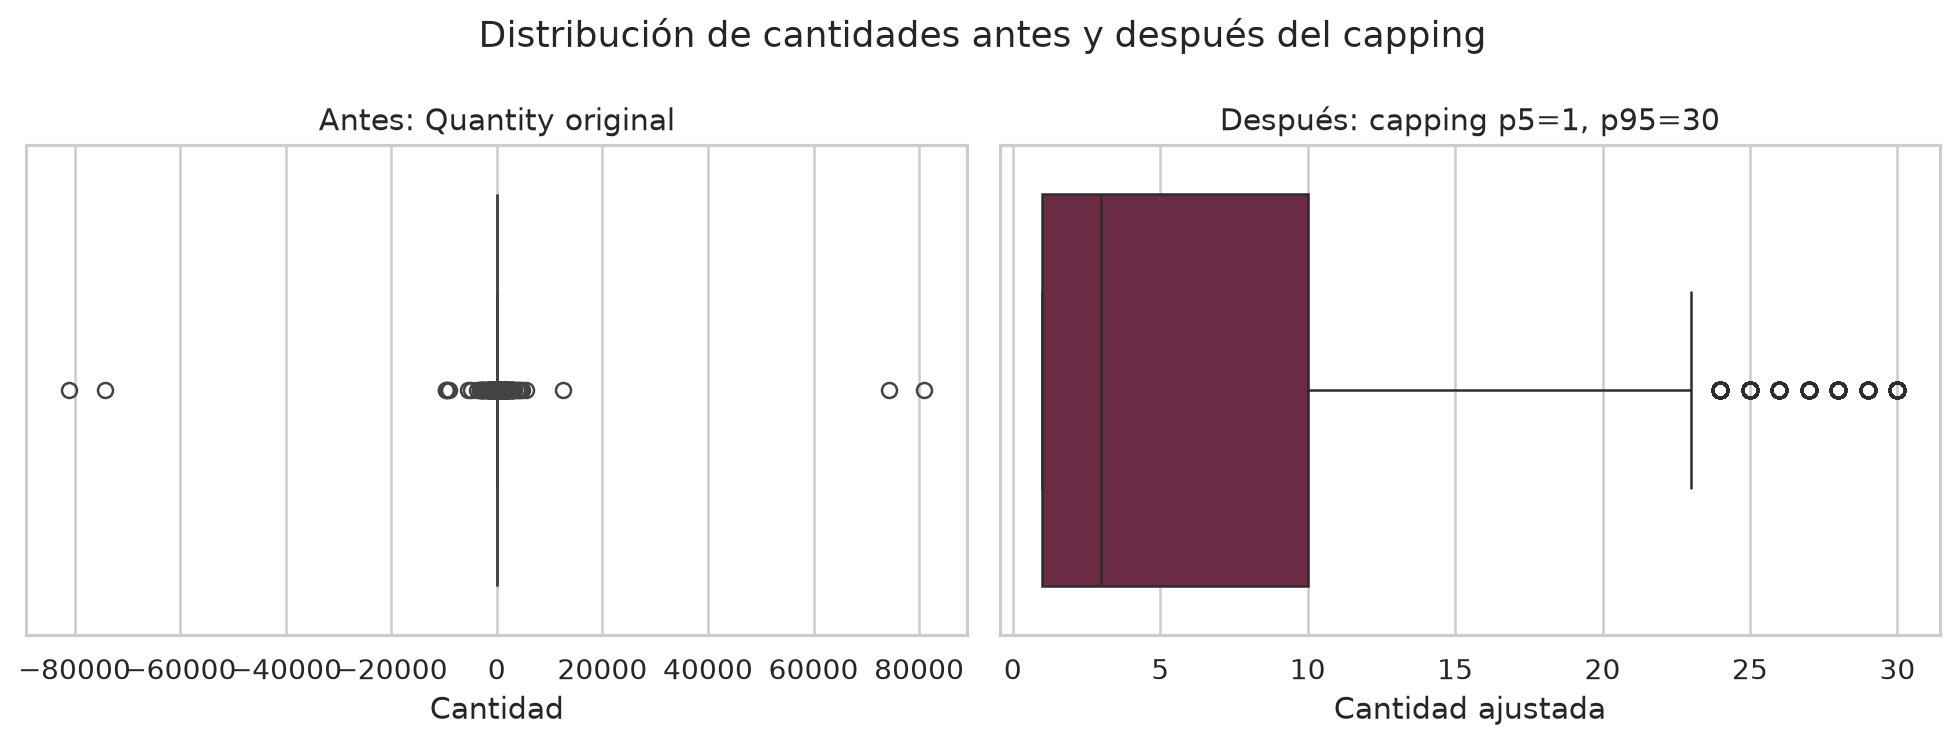
Figura 1. Cantidad original y cantidad ajustada. Fuente: notebook de la práctica, elaborado con la copia CSV de Online Retail.
El ajuste cambió 36,222 cantidades. Como el límite inferior fue 1, las 10,475 cantidades negativas pasaron a ser positivas, incluidas las 9,139 cancelaciones. Después del ajuste hay 528,721 filas con cantidad y precio positivos; este conteo no sustituye la validación hecha sobre el dato original.
Los dos listados de importes mayores muestran el efecto de la transformación:
| Orden | Folio original | Total original (GBP) | Folio ajustado | Total ajustado (GBP) | ¿Cancelación ajustada? |
|---|---|---|---|---|---|
| 1 | 581483 | 168,469.60 | C556445 | 38,970.00 | Sí |
| 2 | 541431 | 77,183.60 | 556444 | 19,485.00 | No |
| 3 | 556444 | 38,970.00 | C580605 | 17,836.46 | Sí |
| 4 | 537632 | 13,541.33 | C540117 | 16,888.02 | Sí |
| 5 | A563185 | 11,062.06 | C540118 | 16,453.71 | Sí |
El mayor total ajustado corresponde a una cancelación. Estos importes describen el DataFrame transformado; no deben presentarse como ventas reales. Las columnas originales y
Es_Cancelacionpermiten revisar su significado.
7. Normalización de productos y países
Normalicé los países a mayúsculas, retiré espacios de los extremos y colapsé espacios repetidos. Antes de unificar las descripciones había 1,324 productos con más de una descripción. La regla personalizada se aplicó a los códigos que contienen 0155: el código 90155 aparece en siete filas. Usé su descripción modal y añadí [UNIFICADO_0155].
df["Country"] = (
    df["Country"].astype("string")
    .str.replace(r"\s+", " ", regex=True).str.strip().str.upper()
)
mascara = df["StockCode"].str.contains(identificador, regex=False, na=False)
if mascara.any():
    moda_por_stock = (
        df.loc[mascara].groupby("StockCode")["Description"]
        .agg(lambda serie: serie.mode().iloc[0])
    )
    df.loc[mascara, "Description"] = (
        df.loc[mascara, "StockCode"].map(moda_por_stock)
        + f" [UNIFICADO_{identificador}]"
    )
La categoría de producto se obtuvo de StockCode. Primero revisé si contenía gift, después si contenía cualquier letra y, en los demás casos, lo clasifiqué como producto normal.
| Categoría de producto | Registros |
|---|---|
| REGALO_0155 | 34 |
| PRODUCTO_ESPECIAL | 53,925 |
| PRODUCTO_NORMAL | 477,266 |
8. Segmentación y resultados finales
El umbral fue 2023630155 % 50 + 10 = 15 libras. Clasifiqué cada registro según su total ajustado: menos de 15 como BAJO_VALOR, y 15 o más como ALTO_VALOR. Aunque la columna se llama Categoria_Cliente, la clasificación corresponde a transacciones, no a clientes únicos ni a su gasto acumulado.
umbral = int(boleta_completa) % 50 + 10
df["Total_Venta_Original"] = df["Total_Transaccion_Original"]
df["Total_Venta"] = df["Total_Transaccion"]
df["Categoria_Cliente"] = np.where(
    df["Total_Venta"] < umbral, "BAJO_VALOR", "ALTO_VALOR"
)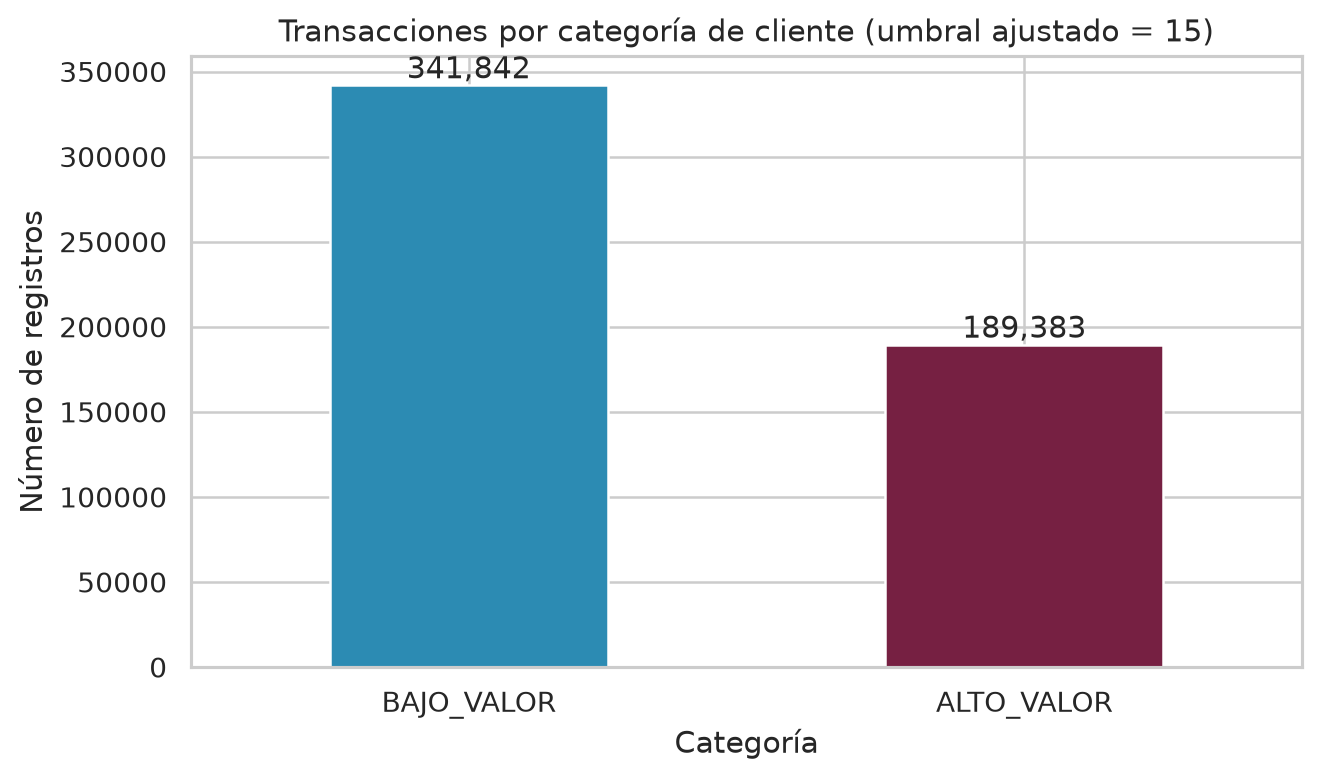
Figura 2. Registros por categoría calculada con el importe ajustado. Fuente: notebook de la práctica.
| Métrica | Resultado |
|---|---|
| Filas originales | 541,909 |
| Filas finales | 531,225 |
| Filas eliminadas por clave de negocio | 10,684 |
| Transacciones válidas con valores originales | 519,582 |
| Transacciones positivas después del ajuste | 528,721 |
| Cancelaciones conservadas | 9,139 |
| Clientes reales distintos | 4,372 |
| Identificadores distintos, incluido 10155 | 4,373 |
| Productos distintos | 4,070 |
| Total positivo original | 10,587,015.733 GBP |
| Total positivo ajustado | 8,446,757.503 GBP |
| Total neto original | 9,683,331.923 GBP |
| Total neto ajustado | 8,424,633.383 GBP |
| Registros de bajo valor / alto valor | 341,842 / 189,383 |
| Filas que contienen 0155 | 134,566 |
La búsqueda de 0155 se hizo en InvoiceNo, StockCode, Description, CustomerID y Country. La mayoría de coincidencias procede de 10155, por lo que el conteo no equivale a clientes reales ni a productos distintos.
9. Exportación, calidad y reproducción
El CSV limpio conserva los datos transformados y las columnas de auditoría. Las comprobaciones programadas obtuvieron 100 % de completitud, unicidad de la clave, coherencia de la bandera de cancelación, cumplimiento del rango capeado y normalización de países. Son verificaciones de reglas concretas; no prueban que cada importe sea una venta económicamente válida.
El notebook descargable contiene las salidas de la ejecución guardada, sin celdas con errores. Para repetir el procedimiento en Google Colab se puede subir y ejecutar completo: descarga el CSV original cuando no lo encuentra en datos/raw/. La ejecución conservada se hizo localmente; no se afirma una ejecución remota en Colab.
Para ejecutarlo con Jupyter, instala las dependencias de la práctica, abre el notebook desde la carpeta de trabajo y ejecuta las celdas en orden:
python3 -m venv .venv
.venv/bin/python -m pip install -r requirements.txt
.venv/bin/jupyter lab practica_01_limpieza_datos_0155.ipynb
Las exportaciones del notebook quedan en datos/processed/: el CSV limpio, el resumen estadístico y los dos listados de cinco importes mayores. Las gráficas se guardan en assets/. Las evidencias pequeñas se pueden consultar aquí:
- Notebook con código y resultados.
- Reporte estadístico JSON y CSV.
- Cinco importes originales mayores.
- Cinco importes ajustados mayores.
- Reporte PDF con la plantilla ESCOM.
10. Conclusiones
Completé la limpieza sobre el conjunto completo y conservé un notebook ejecutado que permite revisar la descarga, los criterios personalizados y las exportaciones. La clave de negocio quedó sin repeticiones, se resolvieron los nulos y todas las fechas se convirtieron al tipo esperado.
El capping fue la decisión con mayor efecto sobre la interpretación. Al fijar el límite inferior en 1, cambió devoluciones y cancelaciones a cantidades ajustadas positivas. Por eso separé los totales originales de los transformados y mantuve las banderas para auditar cada fila.
La imputación con un único identificador también limita un análisis posterior de clientes. Para estudiar su comportamiento habría que excluir 10155 o tratarlo como categoría desconocida. La completitud del archivo no recupera la identidad que falta en el dato de origen.
Fuentes
- Chen, D. (2015). Online Retail. UCI Machine Learning Repository. Procedencia, variables y significado de las cancelaciones.
- Databricks: copia CSV de Online Retail. Archivo utilizado en la práctica.
- pandas: DataFrame.drop_duplicates. Eliminación por columnas de la clave.
- pandas: to_datetime. Conversión de fechas.
- pandas: Series.clip. Recorte de valores a límites.